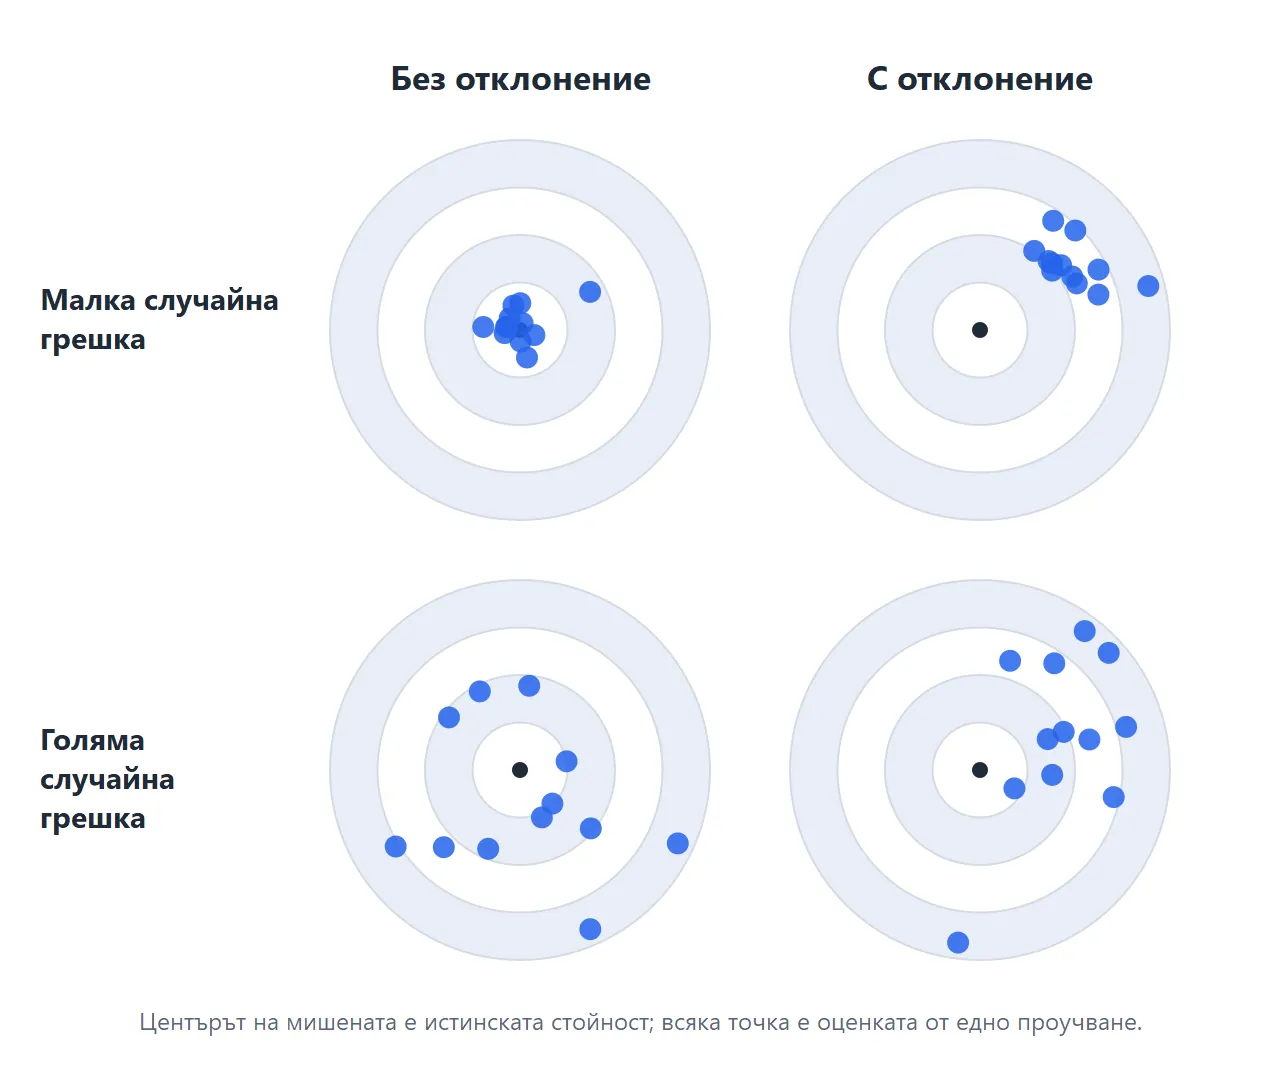
Когато в едно проучване се говори за статистическа грешка, най-често се има предвид стохастичната (случайна) грешка: разликата, която се появява, защото сте попитали извадка, а не всички. Тя намалява по предвидим начин, когато извадката расте, а при случайна извадка може да се изчисли. Отклонението е нещо друго – систематична грешка, която тласка резултатите в една посока. То идва от това кой е в списъка ви, кой отговаря и как са зададени въпросите, и повече отговори не го премахват. Затова срещу стохастичната грешка помагат повече отговори, а срещу отклонението – само по-добре планирано проучване. Статията е за всеки, който провежда или чете анкети: в нея ще намерите сравнение в таблица, допустимата грешка при различен брой отговори, местата, през които отклоненията влизат в онлайн анкетата, и правило с какво се намалява всяка от двете грешки.
Най-важното
- Стохастичната грешка е случайна: измества резултатите ту нагоре, ту надолу и намалява, когато извадката расте. За да я намалите наполовина, ви трябват четири пъти повече отговори.
- Отклонението е систематично: тласка резултатите в една посока и не намалява с по-голяма извадка.
- Допустимата грешка (±) обхваща само стохастичната грешка и само при случайна извадка. За отклоненията тя не казва нищо.
- Стохастичната грешка се намалява с повече отговори от случайна извадка, а отклонението – с по-добър списък, повторни покани до неотговорилите и по-добри въпроси.
Какво е стохастична грешка (извадкова грешка)
Стохастичната грешка, наричана още случайна или извадкова грешка, е разликата между стойността, получена от извадка, и стойността, която бихте получили, ако попитате всички в групата. Тя съществува само защото сте попитали част от хората: пълното изследване, например преброяването, няма такава грешка.
Причината е случайността в това кои хора попадат в извадката. Две случайни извадки по 200 души от клиентите с карта за лоялност на една верига могат да покажат съответно 41 % и 45 % „много доволни“. Нито една от тях не греши: всяка съдържа малко по-различни хора и тъкмо това разсейване е стохастичната грешка. В една извадка тя е нагоре, в друга – надолу, а средно се уравновесява.
При вероятностна извадка, в която всеки от списъка е имал предварително известна вероятност да бъде избран, стохастичната грешка може да се изчисли: като стандартна грешка, доверителен интервал или допустима грешка. Ако пък поканите всички в групата, извадкова грешка няма; към този случай се връщаме в раздела за размера на извадката.
Какво е отклонение (систематична грешка)
Отклонението, или систематичната грешка, е грешка, която изтласква резултатите на проучването в една посока. Ако питате само жени за продукт, който купуват и мъже, всяка оценка ще се накланя на една и съща страна, колкото и жени да отговорят. Отклонението е систематичната част от неизвадковите грешки – всички грешки, които не идват от самото теглене на извадка. Когато се дължи на това кой в крайна сметка отговаря, често го наричат отклонение при подбора, но то не е извадкова грешка.
Случайната грешка средно се уравновесява, отклонението – не. Както отбелязва Статистическата служба на Канада, по-голяма извадка не намалява отклонението, причинено от систематични грешки. Анкетата на списание Literary Digest от 1936 г. имаше огромна извадка и въпреки това предсказа съвсем погрешно изхода от президентските избори в САЩ, защото и списъкът ѝ, и това кой върна бюлетините бяха с отклонение (Squire, Public Opinion Quarterly, 1988).
За отклонението няма допустима грешка, която да се изчисли. Числото с ± под едно проучване покрива само стохастичната грешка (AAPOR), а грешките от формулировката, от непълния обхват или от неверните отговори трудно се измерват и рядко се съобщават (Pew Research Center). Големината на отклонението се различава от въпрос на въпрос (Pew Research Center, 2017), така че то не прави цялото проучване невалидно. Целта е да го намалите и да посочите в каква посока вероятно действа.
Грешка и отклонение: разликата в една таблица
Разликата е в посоката и в начина, по който всяка от двете се намалява: стохастичната грешка разпръсква резултатите около истинската стойност, а отклонението ги измества встрани от нея.
| Стохастична грешка (извадкова) | Отклонение (систематична грешка) | |
|---|---|---|
| Причина | Случайността в това кой попада в извадката | Кой е в списъка, кой отговаря, как са зададени въпросите |
| Посока | Нагоре или надолу; средно се уравновесява | Винаги в една и съща посока |
| По-голяма извадка | Намалява: четири пъти повече отговори я намаляват наполовина | Не се променя |
| Може ли да се измери | Да, като допустима грешка при случайна извадка | Не от самите отговори; няма допустима грешка |
| Как се намалява | С повече отговори | С по-добър списък, повторни покани, по-добри въпроси, пробно попълване |
В модела на общата грешка на изследването (Groves и Lyberg, Public Opinion Quarterly, 2010) грешката на една стойност обикновено се измерва като нейната дисперсия плюс квадрата на отклонението (средна квадратична грешка). По-голямата извадка свива първото събираемо и оставя второто: голяма извадка с отклонение пак дава грешен резултат, а всеки дизайн на проучване търси баланс между грешката и разходите.
Как размерът на извадката променя допустимата грешка
Допустимата грешка се посочва в процентни пунктове, обикновено при ниво на доверие 95 %, и е най-голяма, когато отговорите се делят 50 на 50. В бележките към социологическите проучвания у нас тя често се нарича „максимална стохастична грешка“. Становището на AAPOR за допустимата грешка на извадката дава следните стойности:
Проста случайна извадка от голяма група, всички поканени отговарят, ниво на доверие 95 %, отговорите се делят 50 на 50 (AAPOR).
| Отговори | Допустима грешка |
|---|---|
| 100 | ±9,8 пункта |
| 200 | ±6,9 пункта |
| 400 | ±4,9 пункта |
| 500 | ±4,4 пункта |
| 1000 | ±3,1 пункта |
| 1500 | ±2,5 пункта |
| 2500 | ±2,0 пункта |
Таблицата приема, че цялата група е много по-голяма от извадката. В малка група, като фирма с 80 служители или клас от 30 ученици, грешката е по-малка, щом сте попитали голяма част от хората. Ако сте поканили всички, извадкова грешка изобщо няма: резултатът е преброяване, а оставащата разлика идва от хората, които не са отговорили или не са отговорили точно.
Четири пъти по-голяма извадка намалява грешката наполовина (±9,8 при 100 отговора, ±4,9 при 400), но преходът от 1000 към 2000 отговора печели само около един пункт. Типично национално проучване с около 1000 души отчита приблизително ±3 пункта. Когато изборно проучване се размине с вота, стохастичната грешка е само една от възможните причини: непълният обхват, формулировката и неверните отговори също действат, но не влизат в ±. Подгрупа от 200 души в извадка от 1000 има около ±6,9 пункта, а претеглянето и ефектът на дизайна правят реалната грешка още по-широка.
Най-важното: допустимата грешка важи само за вероятностни извадки, в които всеки е имал предварително известна, различна от нула вероятност да бъде избран. Тя не важи за доброволни извадки, като отговорите на линк, публикуван в социална мрежа или на уебсайт. За такива извадки допустима грешка не може да се изчисли, а самите отговори не могат да покажат колко са далеч от истината. Отклонението може да се прецени само спрямо нещо, което знаете извън анкетата: състава на цялата група (възраст, населено място, отдел, клиентски сегмент) в сравнение със състава на отговорилите.
Откъде влизат отклоненията в онлайн анкетата
Отклоненията влизат в онлайн анкетата през пет места. Първите три засягат това кой отговаря, последните две – самите отговори (отклонение в отговорите и други грешки от измерването).
Обхват: кой липсва в списъка
Грешката от обхвата идва от непълно покритие: списъкът или каналът ви пропуска част от групата. Проучване сред служителите, изпратено по имейл, не стига до хората без служебен имейл адрес. Преди да изпратите анкетата, проверете кой не е в списъка, и планирайте друг начин да стигнете до тях.
Самоподбор: кой решава да отговори
Линк, публикуван на уебсайт или в социална мрежа, оставя хората сами да решат дали да участват, а най-често отговарят онези със силно мнение. Вместо това поканете определен списък. За да не допуснете непоканени хора, включете „Анкетата може да бъде попълнена само чрез покана по имейл“, което изключва директния линк и всички други начини за разпространение, и заедно с нея изберете „Следете получените отговори“. Проследяването е изключено по подразбиране, а без него ограничението не пуска нито един от поканените. При включено проследяване всеки отговор се свързва с получателя си и поканата съобщава това на получателите. Ограничението спира непоканените, но не прави извадката случайна.
Липса на отговори: кой не е отговорил
Отклонението от липса на отговори зависи от две неща едновременно: колко от поканените не са отговорили и колко се различават те от отговорилите. Нисък дял на отговорилите при малка разлика вреди малко; висок дял при много различна липсваща група пак може да подведе. Затова процентът на отговорите сам по себе си не показва колко голямо е отклонението.
Липса на отговори има и вътре в анкетата. Гледайте броя отговори на всеки въпрос, а не само броя попълнени анкети: резултатът по чувствителен въпрос, който половината респонденти са пропуснали, носи отклонение от липса на отговори, дори когато анкетата като цяло е събрала добър дял отговори.
Направете анкетата кратка, приложете тези съвети как повече от поканените да отговорят и изпращайте покани и повторни покани по имейл. При включено „Следете получените отговори“ филтърът за получатели „Не са отговорили на досегашна имейл покана“ изпраща повторната покана само до хората, които не са отворили анкетата от поканата си. След това сравнете състава на отговорилите със състава на групата. Сравнението между ранните и късните респонденти е подсказка, а не проверка: хората, отговорили след повторна покана, все пак са отговорили. Причините и мерките са описани подробно в статията за отклоненията, породени от липса на отговори.
Формулировка и ред на въпросите
Сугестивните и „заредените“ въпроси тласкат отговорите в една посока, двойните въпроси ги размиват, а дори една дума може да промени резултата: Pew Research Center съобщава, че в САЩ „помощ за бедните“ получава повече подкрепа от „социални помощи“. Избягвайте сугестивните и заредените въпроси, разделяйте двойните въпроси на два и дайте анкетата за пробно попълване на неколцина души от групата.
Въпросите, които надграждат един друг, оставете в постоянен ред (общото преди конкретното, въпросът-филтър преди уточняващите въпроси след него). Паралелните елементи, например списък с марки, отдели или твърдения, показвайте в случаен ред, така че нито един да не е винаги пръв. Това разпределя ефекта от реда равномерно, но не го премахва. В редактора това е „случайна подредба на редовете“ в матричен въпрос; „случайна подредба на колонките“ използвайте само когато колоните са неподредени категории, никога за скала за оценка. Настройката „Случайна подредба на въпроси“ разбърква въпросите на всяка страница от анкетата, затова я включвайте само когато всяка страница съдържа единствено паралелни въпроси. Отговорите на въпрос с избор не се разбъркват.
Социално желани отговори
Хората съобщават по-рядко поведение, което околните не одобряват, и по-често онова, което се одобрява: това е ефектът на социалната желателност, вид отклонение в отговорите. Въпросът „Заклет пушач ли сте?“ кара част от заклетите пушачи да отговорят „не“. Питайте неутрално и давайте интервали вместо етикети: „Колко цигари изпушвате в обикновен ден?“ с отговори „Нито една“, „1–5“, „6–10“ и т.н. Онлайн формулярът премахва анкетьора: ефектът отслабва, но не изчезва. Повече за деликатните теми ще намерите в статията какво да правим с чувствителните въпроси в анкетата. При телефонните и личните интервюта се добавя отклонението заради намесата на анкетьора, а грешките при кодирането и въвеждането на данните са още един източник на грешка.
Случайност или отклонение? Как да разчетете неочакван резултат
Когато резултат ви изненада, сравнете разликата между него и очакваното с допустимата грешка. Ако разликата е много по-голяма, отколкото случайността позволява, или извадката не е случайна, търсете отклонение и посоката, в която то действа.
Да кажем, че сте попитали 100 души, които приемаме за случайна извадка от клиентите ви, и 20 % от тях предпочитат новия шоколад с млян лешник, а по-късно надеждни данни за всички клиенти показват около 33 %. Разликата е 13 процентни пункта, а не 13 %. Допустимата грешка при 100 отговора е около ±10 пункта; приблизително 1 от 20 случайни извадки излиза извън нея и почти никоя не стига толкова далеч, така че случайността едва ли обяснява разликата. Питайте кой е бил поканен и кой е отговорил. Ако стоте отговора са дошли от споделен линк, прескочете допустимата грешка и започнете направо с тези въпроси.
Сравнението на две групи изисква по-широка граница. Два отдела с по 200 отговора имат около ±7 пункта всеки, но разликата между тях има около ±10. Разлика от 6 пункта е в рамките на случайността, а от 15 пункта – не. Същото важи за тази година спрямо миналата.
Линк в бюлетин, който носи 500 попълнени анкети, не заслужава ±4,4 пункта от таблицата: респондентите са се избрали сами, а дори случайни 500 души биха описали само абонатите, не всички клиенти, и не биха казали нищо за абонатите, които не са отговорили. Посочете броя отговори, канала и групите, които вероятно са слабо представени.
Повече отговори или по-добро проучване: кое решение за коя грешка
Минете през този списък преди изпращането и отново преди отчета.
- Случайна извадка от голяма група, но допустимата грешка е твърде широка за решението ви: съберете повече отговори, но не очаквайте много след около 1000.
- Липсващи или слабо представени групи: повече отговори от същия канал няма да помогнат; сменете списъка или канала. Ако съставът на отговорилите се различава от този на групата по признак, който знаете за всички (населено място, отдел, възрастова група), отчетете резултатите по тези групи или претеглете данните след експорт: инструментът не претегля отговорите. Претеглянето коригира само признаците, по които претегляте, не и мненията на неотговорилите, и разширява допустимата грешка.
- Поканили сте цялата група: повече отговори означава да потърсите хората, които още не са отговорили, а не по-голяма извадка.
- Съмнения във въпросите: направете пробно попълване и преработете въпросите с помощта на тези съвети за ясни и неутрални въпроси. Разбърквайте само паралелни елементи, никога въпроси, които надграждат един друг.
- Отчет: посочете броя отговори и как са поканени хората, допустима грешка само при случайна извадка и в каква посока вероятното отклонение би изместило резултатите.
Стохастичната грешка и отклонението изискват различни решения. Случайната грешка намалява с всеки добавен отговор, а при случайна извадка допустимата грешка показва колко е останало от нея. Отклонението остава, колкото и отговори да съберете; то отстъпва само пред списък, който обхваща цялата група, повторни покани до онези, които не са отговорили, и неутрални, изпробвани въпроси.
За да приложите това на практика, започнете от шаблона за пазарно проучване по-долу и го изпратете на определен списък, а не като публичен линк.
Готов шаблон: пазарно проучване
Вижте шаблона